GroupDocs.Parser en un coup d’œil

SDK d’analyseur de documents pour réaliser une analyse de documents haute précision dans les applications Node.js

Illustration parser

Extraire des données à partir de documents

GroupDocs.Parser for Node.js via Java API vous permet de récupérer le texte, les métadonnées et les images d’une large gamme de formats de fichiers tels que les documents Office, les e‑mails, les pièces jointes et les archives. Cet outil puissant vous aide à accéder et à traiter efficacement les informations précieuses contenues dans ces fichiers pour diverses applications telles que l’analyse de données, l’indexation pour moteurs de recherche ou les systèmes de gestion de contenus.

Analyser les documents

Extrayez divers éléments tels que les hyperliens, les tableaux, les codes QR, les codes-barres et les données des formulaires PDF. Analysez également toute information souhaitée à partir de documents à l’aide de modèles personnalisés.

Personnaliser les résultats

Node.js API vous permet de récupérer des données sous divers formats tels que brut, structuré, HTML ou Markdown. De plus, l’API propose une fonction de recherche pour localiser des mots ou des expressions spécifiques dans le texte des documents.

Indépendance de plateforme

GroupDocs.Parser for Node.js via Java prend en charge les systèmes d’exploitation, frameworks et gestionnaires de paquets suivants

Windows
macOS
Linux
NPM
Amazon
Docker
Azure
VS Code
IntelliJ

Formats de fichiers pris en charge

GroupDocs.Parser for Node.js via Java prend en charge les opérations avec les formats de fichier suivants.

Formats Microsoft Office

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLTM, XLT, XLTM, XLTX, XLAM, SXC, SpreadsheetML
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM

Images et autres formats

  • Portable: PDF
  • Images: JPG, BMP, PNG, TIFF, GIF
  • Autres formats Office: ODT, OTT, OTS, ODS, ODP, OTP, ODG

Autres formats

  • Web: HTML, MHTML
  • Archives: ZIP, TAR, 7Z
  • e-books: CHM, EPUB, FB2, MOBI

Fonctionnalités GroupDocs.Parser for Node.js via Java

Extrayez des données des PDF, documents Office, images et autres formats rapidement et avec précision grâce à notre SDK d’analyseur de documents Node.js

Feature icon

Extraire du texte

Extrayez les informations textuelles de divers formats de fichiers tels que les documents Office, les fichiers PDF et les images pour une lecture et une analyse faciles.

Feature icon

Extraire des images

Récupérez le contenu visuel provenant de diverses sources telles que les documents Office et les fichiers PDF pour un accès et une utilisation pratiques.

Feature icon

Scanner les codes QR

Détectez et décodez les codes QR présents dans les documents Office, les fichiers PDF ou le contenu visuel pour une récupération efficace de l’information.

Feature icon

Extraire des données des pièces jointes d’e‑mail et des archives

Collectez des informations précieuses à partir de messages e‑mail, de pièces jointes de fichiers et de sources de données compressées pour une analyse et une utilisation efficaces.

Feature icon

Extraire des tableaux

Identifiez et extrayez les données tabulaires des documents PDF pour une analyse et une utilisation organisées.

Feature icon

Extraire des hyperliens

Localisez et extrayez les hyperliens et les adresses e‑mail dans les documents Office ou les fichiers PDF pour un accès efficace.

Feature icon

Analyser les formulaires PDF

Les formulaires PDF sont des documents numériques comportant des champs remplissables pour l’interaction de l’utilisateur, permettant de saisir des informations électroniquement. L’API Node.js peut être utilisée pour extraire les données de ces formulaires afin d’optimiser le traitement.

Feature icon

Analyser les données avec des modèles

Créez des modèles personnalisés et utilisez‑les avec l’API Node.js pour analyser des informations spécifiques à partir de fichiers PDF, simplifiant ainsi les processus d’extraction de données.

Feature icon

Rechercher du texte dans des documents

Localisez rapidement des mots ou des modèles spécifiques dans les documents.

Exemples de code

Au‑delà de l’extraction de texte de base, voici les cas d’utilisation les plus courants pour une extraction rapide de texte, d’images et de métadonnées.

Rechercher du texte dans un document

Cet exemple montre comment rechercher un mot dans un document PDF et afficher la page ainsi que la position de chaque correspondance.

Rechercher du texte dans un document en JavaScript

const groupdocs = require('@groupdocs/groupdocs.parser');

// Charger le document
const parser = new groupdocs.Parser("sample.pdf");

// Rechercher un mot page par page
const options = new groupdocs.SearchOptions(false, false, false, true);
const results = parser.search("Lorem", options);

// Afficher l'index de page, la position et le texte de chaque correspondance
const it = results.iterator();
while (it.hasNext()) {
    const result = it.next();
    console.log(`Page ${result.getPageIndex()}, position ${result.getPosition()}: ${result.getText()}`);
}

parser.close();

Extraire des images d’un document

Cet exemple montre comment extraire des images d’un document PDF et les enregistrer au format PNG.

Extraire des images d’un document en JavaScript

const groupdocs = require('@groupdocs/groupdocs.parser');

// Charger le document
const parser = new groupdocs.Parser("images.pdf");

// Extraire les images du document
const images = parser.getImages();

// Enregistrer les images au format PNG
const options = new groupdocs.ImageOptions(groupdocs.ImageFormat.Png);
let index = 1;
const it = images.iterator();
while (it.hasNext()) {
    it.next().save(`image_${index++}.png`, options);
}

parser.close();

Extraire les métadonnées d’un document

Cet exemple montre comment extraire les métadonnées d’un document PDF et les afficher.

Extraire les métadonnées d’un document en JavaScript

const groupdocs = require('@groupdocs/groupdocs.parser');

// Charger le document
const parser = new groupdocs.Parser("sample.pdf");

// Extraire les métadonnées du document
const metadata = parser.getMetadata();

// Afficher les métadonnées
const it = metadata.iterator();
while (it.hasNext()) {
    const item = it.next();
    console.log(`${item.getName()}: ${item.getValue()}`);
}

parser.close();

Prêt à commencer ?

Téléchargez GroupDocs.Parser gratuitement ou obtenez une licence d’essai pour un accès complet !

Ressources utiles

Explorez la documentation, les échantillons de code et le soutien communautaire pour améliorer votre expérience.

Conseils sur les licences temporaires

1
Inscrivez-vous avec votre adresse e-mail professionnelle. Les services de messagerie gratuits ne sont pas autorisés.
2
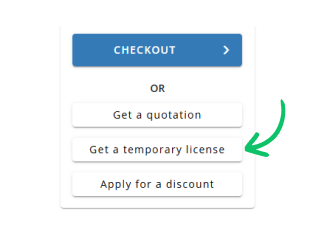
Utilisez le bouton Obtenir une licence temporaire à la deuxième étape.
✕
 Français