GroupDocs.Parser 한눈에 보기

Node.js 애플리케이션에서 고정밀 문서 파싱을 수행하기 위한 Document Parser SDK

Illustration parser

문서에서 데이터 추출

GroupDocs.Parser for Node.js via Java API를 사용하면 Office 문서, 이메일, 첨부 파일 및 아카이브와 같은 다양한 파일 형식에서 텍스트, 메타데이터 및 이미지를 검색할 수 있습니다. 이 강력한 도구는 데이터 분석, 검색 엔진 색인 생성 또는 콘텐츠 관리 시스템과 같은 다양한 애플리케이션에서 파일에 포함된 중요한 정보를 효율적으로 액세스하고 처리하는 데 도움이 됩니다.

문서 파싱

PDF 양식에서 하이퍼링크, 테이블, QR 코드, 바코드 및 데이터를 추출합니다. 또한 사용자 정의 템플릿을 사용해 문서에서 원하는 정보를 파싱할 수 있습니다.

결과 맞춤화

Node.js API를 사용하면 원시, 구조화, HTML 또는 Markdown과 같은 다양한 형식으로 데이터를 검색할 수 있습니다. 또한 API는 문서 텍스트 내에서 특정 단어나 구문을 찾아내는 검색 기능을 제공합니다.

플랫폼 독립성

GroupDocs.Parser for Node.js via Java는 다음 운영 체제, 프레임워크 및 패키지 관리자를 지원합니다.

Windows
macOS
Linux
NPM
Amazon
Docker
Azure
VS Code
IntelliJ

지원되는 파일 형식

GroupDocs.Parser for Node.js via Java는 다음 파일 형식을 지원합니다.

Microsoft Office 형식

  • Word: DOCX, DOC, DOCM, DOT, DOTX, DOTM, RTF
  • Excel: XLSX, XLS, XLSM, XLSB, XLTM, XLT, XLTM, XLTX, XLAM, SXC, SpreadsheetML
  • PowerPoint: PPT, PPTX, PPS, PPSX, PPSM, POT, POTM, POTX, PPTM

이미지 및 기타 형식

  • 휴대용: PDF
  • 이미지: JPG, BMP, PNG, TIFF, GIF
  • 기타 오피스 형식: ODT, OTT, OTS, ODS, ODP, OTP, ODG

기타 형식

  • 웹: HTML, MHTML
  • 아카이브: ZIP, TAR, 7Z
  • 전자책: CHM, EPUB, FB2, MOBI

GroupDocs.Parser for Node.js via Java 기능

우리의 Node.js Document Parser SDK를 사용하여 PDF, Office 문서, 이미지 및 기타 형식에서 데이터를 빠르고 정확하게 추출합니다.

Feature icon

텍스트 추출

Office 문서, PDF 파일 및 이미지와 같은 다양한 파일 형식에서 텍스트 정보를 추출하여 쉽게 읽고 분석할 수 있도록 합니다.

Feature icon

이미지 추출

Office 문서, PDF 파일 등 다양한 소스에서 시각적 콘텐츠를 가져와 편리하게 액세스하고 사용할 수 있습니다.

Feature icon

QR 코드 스캔

Office 문서, PDF 파일 또는 시각적 콘텐츠에 포함된 QR 코드를 감지하고 디코딩하여 효율적으로 정보를 검색합니다.

Feature icon

이메일 첨부 파일 및 아카이브에서 데이터 추출

이메일 메시지, 파일 첨부 및 압축 데이터 소스에서 유용한 정보를 수집하여 효과적인 분석 및 활용에 활용합니다.

Feature icon

테이블 추출

PDF 문서에서 표 형식 데이터를 식별하고 추출하여 체계적인 분석 및 활용에 사용할 수 있습니다.

Feature icon

하이퍼링크 추출

Office 문서 또는 PDF 파일 내에서 하이퍼링크와 이메일 주소를 찾아 추출하여 효율적으로 접근할 수 있습니다.

Feature icon

PDF 양식 파싱

PDF 양식은 사용자가 전자적으로 정보를 입력할 수 있는 채워질 수 있는 필드를 갖춘 디지털 문서입니다. Node.js API를 사용하여 이러한 양식에서 데이터를 추출하고 효율적으로 처리할 수 있습니다.

Feature icon

템플릿으로 데이터 파싱

사용자 정의 템플릿을 만들어 Node.js API와 함께 사용하여 PDF 파일에서 특정 정보를 파싱함으로써 데이터 추출 프로세스를 단순화합니다.

Feature icon

문서에서 텍스트 검색

문서 내에서 특정 단어나 패턴을 빠르게 찾습니다.

코드 샘플

기본 텍스트 추출을 넘어, 빠른 텍스트, 이미지 및 메타데이터 추출을 위한 가장 일반적인 사용 사례입니다.

문서에서 텍스트 검색

이 예제는 PDF 문서에서 단어를 검색하고 일치하는 모든 결과의 페이지와 위치를 출력하는 방법을 보여줍니다.

JavaScript에서 문서 텍스트 검색

const groupdocs = require('@groupdocs/groupdocs.parser');

// 문서 로드
const parser = new groupdocs.Parser("sample.pdf");

// 페이지별로 단어 검색
const options = new groupdocs.SearchOptions(false, false, false, true);
const results = parser.search("Lorem", options);

// 각 일치 항목의 페이지 인덱스, 위치 및 텍스트 출력
const it = results.iterator();
while (it.hasNext()) {
    const result = it.next();
    console.log(`Page ${result.getPageIndex()}, position ${result.getPosition()}: ${result.getText()}`);
}

parser.close();

문서에서 이미지 추출

이 예제는 PDF 문서에서 이미지를 추출하고 PNG 파일로 저장하는 방법을 보여줍니다.

JavaScript에서 문서 이미지 추출

const groupdocs = require('@groupdocs/groupdocs.parser');

// 문서 로드
const parser = new groupdocs.Parser("images.pdf");

// 문서에서 이미지 추출
const images = parser.getImages();

// 이미지를 PNG 파일로 저장
const options = new groupdocs.ImageOptions(groupdocs.ImageFormat.Png);
let index = 1;
const it = images.iterator();
while (it.hasNext()) {
    it.next().save(`image_${index++}.png`, options);
}

parser.close();

문서에서 메타데이터 추출

이 예제는 PDF 문서에서 메타데이터를 추출하고 출력하는 방법을 보여줍니다.

JavaScript에서 문서 메타데이터 추출

const groupdocs = require('@groupdocs/groupdocs.parser');

// 문서 로드
const parser = new groupdocs.Parser("sample.pdf");

// 문서에서 메타데이터 추출
const metadata = parser.getMetadata();

// 메타데이터 출력
const it = metadata.iterator();
while (it.hasNext()) {
    const item = it.next();
    console.log(`${item.getName()}: ${item.getValue()}`);
}

parser.close();

시작할 준비가 되셨나요?

GroupDocs.Parser를 무료로 다운로드하거나 전체 액세스를 위한 평가판 라이센스를 받으세요!

유용한 리소스

경험을 향상시키기 위해 문서, 코드 샘플 및 커뮤니티 지원을 탐색하십시오.

임시 라이센스 팁

1
직장 이메일로 가입하세요. 무료 메일 서비스는 허용되지 않습니다.
2
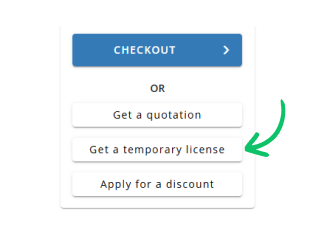
두 번째 단계에서 임시 라이센스 받기 버튼을 사용하세요.
✕
 한국인